GUIDE DÉFINITIF & MONOGRAPHIE • INFÉRENCE ET SOUVERAINETÉ PRIVÉE
IA en Local : Inférence Privée, Outils et Matériel
Souveraineté technique, confidentialité absolue et contrôle total : le guide pratique pour télécharger, exécuter et maîtriser les modèles de langage ouverts sur votre propre matériel sans dépendre du cloud.
Pourquoi envoyer les données les plus sensibles de votre entreprise ou de vos projets personnels vers des serveurs tiers quand vous pouvez exécuter des modèles de pointe sur votre propre machine ? L’inférence locale a cessé d’être l’apanage des seuls ingénieurs systèmes. Aujourd’hui, tout professionnel ou organisation peut déployer de puissants modèles de langage (LLM), de la vision par ordinateur et des systèmes RAG documentaires en totale confidentialité et sans coût récurrent.
Les 4 Grands Avantages de l’Inférence Locale
🔒
Confidentialité et RGPD
Vos contrats, dossiers médicaux, code source et notes ne quittent jamais votre machine et ne servent jamais à réentraîner des modèles tiers.
💸
Zéro Abonnement et Sans API
Supprimez les abonnements mensuels de 20 $/mois par utilisateur et l’incertitude d’une facturation variable aux tokens consommés.
⚡
100% Autonome et Hors Ligne
Travaillez en avion, dans des zones sans réseau ou dans des environnements critiques sans redouter d’interruption de service des fournisseurs cloud.
🛡️
Souveraineté sans Censure
Des modèles ouverts aux poids vérifiables, sans filtres corporatifs imprévisibles ni dégradation silencieuse des performances.
1. Logiciels Indispensables : Du Terminal au RAG Privé en un Clic
Plus besoin de compiler du code ni de vous battre avec des bibliothèques complexes. Ces outils open source et applications de bureau rendent l’exécution d’une IA locale aussi simple que l’installation d’un logiciel classique.
 ENVIRONNEMENT DE BUREAU
LM Studio : La méthode la plus visuelle pour dialoguer avec les LLM
Découvrez et téléchargez des modèles quantifiés directement depuis Hugging Face, ajustez les paramètres d’inférence et démarrez un serveur local compatible avec l’API d’OpenAI.
 RAISONNEMENT AVANCÉ
DeepSeek en Local : Téléchargement et Utilisation Pas à Pas
Comment exécuter les poids de DeepSeek et ses distillations via Ollama ou LM Studio pour la programmation, les mathématiques et la logique sans connexion extérieure.
 RAG D’ENTREPRISE PRIVÉ
AnythingLLM : Interrogez vos Documents sans Aucune Fuite
La solution tout-en-un pour indexer des dossiers entiers de PDF, DOCX et feuilles de calcul avec des embeddings locaux et des citations rigoureuses des sources d’origine.
 AUTOMATISATION & INTERFACE WEB
Pinokio AI : Installez des Environnements Complexes en 1 Clic
Le navigateur qui automatise les terminaux Git, environnements Conda et dépendances Python pour faire tourner Stable Diffusion, Whisper, ComfyUI et FaceFusion sans accroc.
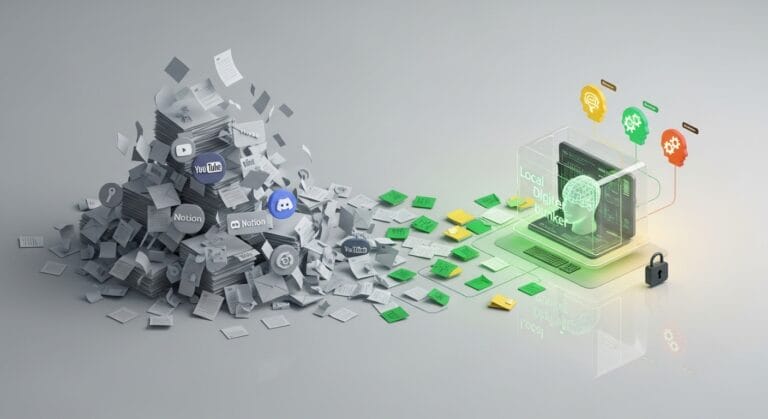 BASE DE CONNAISSANCES LOCALE
Surfsense : L’Alternative Privée à NotebookLM
Bâtissez votre second cerveau numérique et centralisez vos notes, pages web et documents avec une recherche hybride et la génération de synthèses locales sur votre poste.
2. Guide Matériel : La Règle d’Or de la VRAM, des GPU et des NPU
En intelligence artificielle, la mémoire vidéo (VRAM) de la carte graphique est le critère déterminant. Si le modèle et sa fenêtre de contexte logent intégralement dans la VRAM, la réponse est quasi instantanée ; s’il déborde sur la mémoire vive (RAM) du système, la vitesse de traitement s’effondre.
8 Go VRAM
Modèles de 3B à 8B quantifiés en 4 bits (Llama 3.2 3B, Qwen 2.5 7B Q4). Idéal pour débuter et concevoir des assistants de base.
12 Go VRAM
Modèles de 8B à 14B avec fenêtres de contexte étendues (8k à 16k tokens) sans goulot d’étranglement sur RTX 3060/4070.
16 Go VRAM
L’équilibre professionnel parfait : DeepSeek-R1 Distill 14B, Qwen 14B et flux de RAG sur des milliers de pages sur RTX 4080 / Mac Apple Silicon.
24 Go+ VRAM
Stations de travail haut de gamme (RTX 3090/4090) : modèles de 32B et 70B pour le développement de code complexe et le fine-tuning.
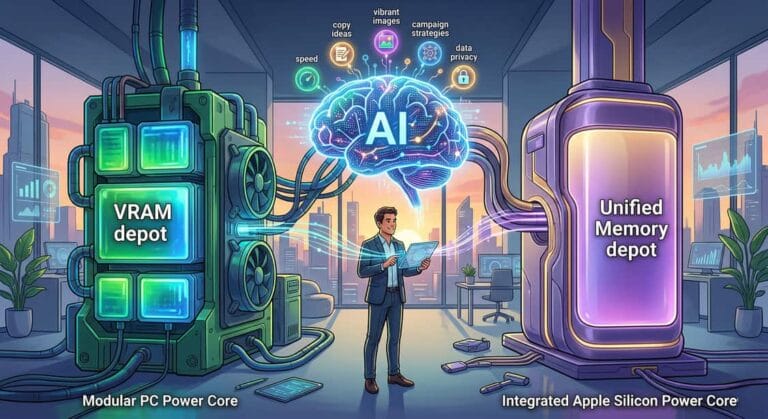 GUIDE D’ACHAT 2026
Vaut-il la peine d’investir dans un PC pour l’IA en 2026 ?
Analyse du ROI face aux abonnements cloud, composants clés (carte mère, bande passante PCIe, alimentation) et configurations recommandées selon votre budget.
 ARCHITECTURE & SILICIUM
Nvidia : L’Écosystème Dominant de l’IA
Pourquoi les cœurs Tensor et la bibliothèque CUDA constituent le standard incontournable de l’industrie pour exécuter des modèles sans incompatibilités techniques.
 PUCES NEURONALES INTÉGRÉES
Processeurs avec NPU : Le Nouveau Standard
Ce qu’apportent les unités de traitement neuronal intégrées (Intel Core Ultra, AMD Ryzen AI, Snapdragon X) face aux cartes graphiques dédiées.
3. Modèles Ouverts et Format GGUF : La Quantification Expliquée
Les modèles d’origine sont entraînés avec des poids en virgule flottante sur 16 bits (FP16), réclamant jusqu’à 2 octets par paramètre. La quantification au format GGUF compresse mathématiquement ces poids en 4 ou 5 bits (comme le standard Q4_K_M), réduisant l’empreinte mémoire de 70% pour une dégradation de précision inférieure à 1%.
| Modèle Recommandé | Paramètres | Format / Quant. | VRAM Recommandée | Spécialité Principale |
|---|---|---|---|---|
| Llama 3.2 3B | 3.2B | GGUF Q4_K_M | 4 – 6 GB | PC portables légers, résumés rapides et classification |
| Qwen 2.5 7B | 7.6B | GGUF Q4_K_M | 8 GB | Multilingue haute fidélité, programmation et tâches générales |
| DeepSeek-R1 Distill 8B | 8.0B | GGUF Q4_K_M | 8 – 10 GB | Raisonnement analytique poussé, logique mathématique et audit |
| DeepSeek-R1 Distill 14B / Qwen 14B | 14.7B | GGUF Q4_K_M | 12 – 16 GB | Développement logiciel avancé et agents autonomes complexes |
| Qwen 2.5 32B / Llama 3.3 70B | 32B – 70B | GGUF Q4_K_S | 24 GB+ | Capacités comparables à GPT-4o pour la production en entreprise |
4. Applications Professionnelles : Du Secret Professionnel à l’Entreprise Souveraine
L’intelligence artificielle locale est la seule alternative viable pour les filières soumises au secret professionnel et à des réglementations strictes sur la protection des données.
⚖️
Cabinets Juridiques et Conseils
Audit massif de contrats, analyse de jurisprudence et préparation de dossiers sans qu’aucune donnée client n’atteigne des serveurs externes.
🏥
Cliniques et Secteur Médical
Structuration des dossiers médicaux, synthèses de consultations et revue bibliographique sous strict respect du RGPD et du secret médical.
💻
Équipes de Développement et Logiciels
Autocomplétion de code propriétaire, refactorisation et débogage avec des modèles locaux sans exposer la propriété intellectuelle.
🏭
PME et Entreprises Industrielles
Bases de connaissances interactives pour les manuels de machines, processus internes et assistance opérationnelle en réseau local.
Foire Aux Questions sur l’IA en Local
Puis-je exécuter un LLM performant sans carte graphique NVIDIA ?
Oui. Les ordinateurs Apple Mac équipés de puces Apple Silicon (M1/M2/M3/M4) bénéficient d’une mémoire unifiée ultra-rapide permettant d’exécuter de volumineux modèles sans carte dédiée. Sur PC avec processeur x86 classique, il est aussi possible d’exécuter des modèles sur le CPU via llama.cpp, bien que la vitesse de génération soit nettement inférieure.
Quelle est la différence entre Ollama et LM Studio ?
Ollama fonctionne principalement comme un service d’arrière-plan optimisé pour le terminal et les intégrations applicatives via API locale. LM Studio est une application graphique de bureau pensée pour les utilisateurs qui préfèrent explorer les modèles, ajuster les paramètres et dialoguer visuellement sans passer par la console.
Est-il légal d’utiliser des modèles open source comme Llama ou DeepSeek en entreprise ?
Oui. Des modèles tels que Llama 3 (licence communautaire de Meta pour les structures comptant moins de 700 millions d’utilisateurs actifs mensuels) et DeepSeek (licence MIT très permissive) autorisent un usage commercial libre, y compris l’intégration dans des produits internes ou destinés aux clients sans royalties.
Besoin de Déployer des Serveurs ou des Postes d’IA Locale dans votre Entreprise ?
Chez ComunicaGenia, nous concevons et déployons des architectures d’intelligence artificielle privée, des postes de travail spécialisés et des bases de connaissances locales (RAG) pour les organisations exigeant une confidentialité absolue et une souveraineté totale sur leurs données.
Cet article est également disponible en :