GUÍA DEFINITIVA & MONOGRÁFICO • INFERENCIA Y SOBERANÍA PRIVADA
IA en Local: Inferencia Privada, Herramientas y Hardware
Soberanía técnica, privacidad absoluta y control total: la guía práctica para descargar, ejecutar y dominar modelos de lenguaje abiertos en tu propio hardware sin depender de la nube.
¿Por qué enviar los datos más sensibles de tu empresa o tus proyectos personales a servidores de terceros cuando puedes ejecutar modelos de vanguardia en tu propio equipo? La inferencia en local ha dejado de ser un terreno exclusivo para ingenieros de sistemas. Hoy en día, cualquier profesional u organización puede desplegar potentes modelos de lenguaje (LLMs), visión artificial y sistemas RAG documentales con total confidencialidad y coste recurrente cero.
Las 4 Grandes Ventajas de la Inferencia Local
🔒
Privacidad y RGPD
Tus contratos, historiales clínicos, código y notas jamás salen de tu máquina ni son utilizados para reentrenar modelos ajenos.
💸
Cero Cuotas y Sin APIs
Elimina las suscripciones mensuales de 20$/mes por usuario y la incertidumbre de la facturación variable por tokens consumidos.
⚡
100% Autónomo y Offline
Trabaja en aviones, zonas sin conectividad o entornos críticos sin temer caídas de servicio de proveedores en la nube.
🛡️
Soberanía sin Censura
Modelos abiertos con pesajes verificables, sin filtros corporativos impredecibles ni degradación silenciosa de capacidades.
1. Software Esencial: De la Terminal al RAG Privado en un Clic
Ya no necesitas compilar código ni lidiar con librerías complejas. Estas herramientas de código abierto y aplicaciones de escritorio hacen que correr IA en local sea tan sencillo como instalar un programa tradicional.
 ENTORNO DE ESCRITORIO
LM Studio: La forma más visual de chatear con LLMs
Descubre y descarga modelos cuantizados directamente desde Hugging Face, gestiona parámetros de inferencia y levanta un servidor local compatible con la API de OpenAI.
 RAZONAMIENTO AVANZADO
DeepSeek en Local: Descarga y Uso Paso a Paso
Cómo ejecutar los pesos de DeepSeek y sus destilaciones mediante Ollama o LM Studio para tareas de programación, matemáticas y lógica sin conexión externa.
 RAG EMPRESARIAL PRIVADO
AnythingLLM: Consulta tus Documentos sin Fugas
La solución todo-en-uno para indexar carpetas enteras de PDFs, DOCXs y hojas de cálculo con embeddings locales y citas precisas de las fuentes originales.
 AUTOMATIZACIÓN & WEBUI
Pinokio AI: Instala Entornos Complejos en 1 Clic
El navegador que automatiza terminales Git, entornos Conda y dependencias Python para correr Stable Diffusion, Whisper, ComfyUI y FaceFusion sin errores.
 BASE DE CONOCIMIENTO LOCAL
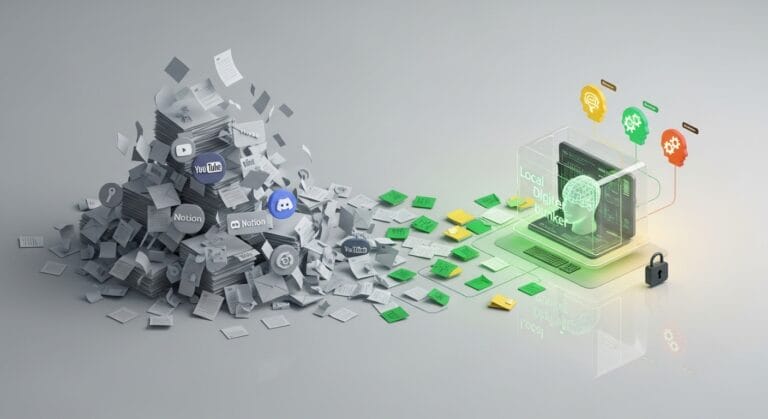
Surfsense: La Alternativa Privada a NotebookLM
Crea tu segundo cerebro digital y centraliza apuntes, páginas web y documentos con búsqueda híbrida y generación de síntesis locales en tu ordenador.
2. Guía de Hardware: La Regla de Oro de la VRAM, GPUs y NPUs
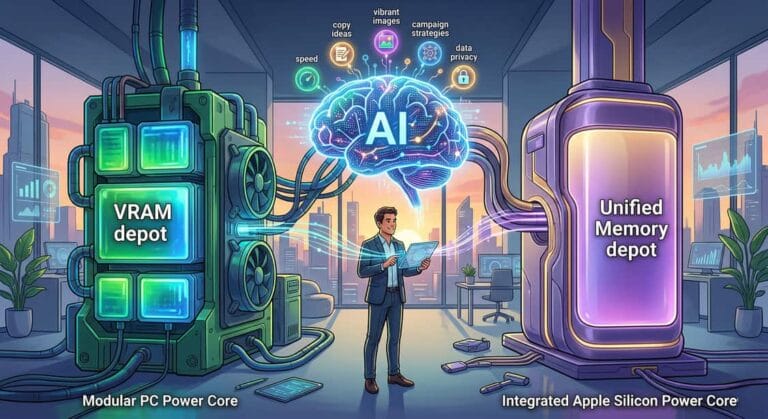
En inteligencia artificial, la memoria de vídeo (VRAM) de la tarjeta gráfica es el factor crítico. Si el modelo y su contexto caben completos en la VRAM, la respuesta es inmediata; si desborda a la RAM general del sistema, la velocidad de procesamiento cae drásticamente.
8 GB VRAM
Modelos 3B a 8B cuantizados a 4 bits (Llama 3.2 3B, Qwen 2.5 7B Q4). Ideal para iniciarse y asistentes básicos.
12 GB VRAM
Modelos de 8B a 14B con ventanas de contexto ampliadas (8k a 16k tokens) sin cuellos de botella en RTX 3060/4070.
16 GB VRAM
El punto dulce profesional: DeepSeek-R1 Distill 14B, Qwen 14B y flujos de RAG con miles de páginas en RTX 4080 / Mac M-Series.
24 GB+ VRAM
Estaciones de trabajo de gama alta (RTX 3090/4090): modelos de 32B y 70B para código avanzado y fine-tuning.
 GUÍA DE COMPRA 2026
¿Vale la pena invertir en un PC para IA en 2026?
Analizamos el ROI frente a las suscripciones cloud, componentes clave (placa, ancho de banda PCIe, fuentes de poder) y configuraciones recomendadas por presupuesto.
 ARQUITECTURA & SILICIO
Nvidia: El Ecosistema Dominante de la IA
Por qué los núcleos Tensor y la biblioteca CUDA son el estándar indiscutible de la industria para ejecutar modelos sin incompatibilidades técnicas.
 CHIPS NEURONALES INTEGRADOS
Procesadores con NPU: El Nuevo Estándar
Qué aportan las unidades de procesamiento neuronal integradas (Intel Core Ultra, AMD Ryzen AI, Snapdragon X) frente a las tarjetas gráficas dedicadas.
3. Modelos Abiertos y Formato GGUF: Cuantización Explicada
Los modelos originales se entrenan con pesos de coma flotante de 16 bits (FP16), requiriendo hasta 2 bytes por parámetro. La cuantización en formato GGUF comprime matemáticamente esos pesos a 4 o 5 bits (como el estándar Q4_K_M), reduciendo el consumo de memoria un 70% con una pérdida de precisión inferior al 1%.
| Modelo Recomendado | Parámetros | Formato / Cuant. | VRAM Recomendada | Especialidad Principal |
|---|---|---|---|---|
| Llama 3.2 3B | 3.2B | GGUF Q4_K_M | 4 – 6 GB | Portátiles ligeros, resúmenes rápidos y clasificación |
| Qwen 2.5 7B | 7.6B | GGUF Q4_K_M | 8 GB | Multilingüe de alta calidad, programación y tareas generales |
| DeepSeek-R1 Distill 8B | 8.0B | GGUF Q4_K_M | 8 – 10 GB | Razonamiento analítico profundo, lógica matemática y auditoría |
| DeepSeek-R1 Distill 14B / Qwen 14B | 14.7B | GGUF Q4_K_M | 12 – 16 GB | Desarrollo de software avanzado y agentes autónomos complejos |
| Qwen 2.5 32B / Llama 3.3 70B | 32B – 70B | GGUF Q4_K_S | 24 GB+ | Capacidades comparables a GPT-4o para producción corporativa |
4. Aplicaciones Profesionales: Del Secreto Profesional a la Empresa Soberana
La inteligencia artificial local es la única alternativa viable para sectores sujetos a secreto profesional y normativas rigurosas de protección de datos.
⚖️
Despachos Legales y Asesorías
Auditoría masiva de contratos, análisis de jurisprudencia y preparación de informes sin que la información de los clientes toque servidores externos.
🏥
Clínicas y Sector Sanitario
Sistematización de historiales médicos, notas de consulta y literatura científica bajo estricto cumplimiento del RGPD y secreto médico.
💻
Equipos de Desarrollo y Software
Autocompletado de código propietario, refactorización y depuración con modelos locales de codificación sin exponer propiedad intelectual.
🏭
Pymes y Empresas Industriales
Bases de conocimiento corporativas interactivas sobre manuales de maquinaria, procedimientos internos y atención operativa en red local.
Preguntas Frecuentes sobre IA en Local
¿Puedo ejecutar un LLM potente si no tengo tarjeta gráfica NVIDIA?
Sí. Los ordenadores Apple Mac con procesadores Apple Silicon (M1/M2/M3/M4) cuentan con memoria unificada de altísima velocidad que permite ejecutar modelos de gran tamaño sin tarjeta dedicada. En PCs con procesador convencional x86, también puedes ejecutar modelos en la CPU mediante llama.cpp, aunque la velocidad de generación será notablemente inferior.
¿Cuál es la diferencia entre usar Ollama y LM Studio?
Ollama funciona principalmente como un servicio de fondo optimizado para la terminal y para integrarse con otras aplicaciones o extensiones vía API local. LM Studio es una aplicación gráfica de escritorio pensada para usuarios que prefieren buscar modelos, ajustar parámetros y chatear visualmente sin usar la consola.
¿Es legal usar modelos de código abierto como Llama o DeepSeek en empresas?
Sí. Modelos como Llama 3 (licencia comunitaria de Meta para organizaciones con menos de 700 millones de usuarios activos mensuales) y DeepSeek (licencia MIT permisiva) permiten el uso comercial libre, incluyendo la integración en productos internos y de cara a clientes sin abonar regalías.
¿Necesitas Desplegar Servidores o Estaciones de IA Local en tu Empresa?
En ComunicaGenia diseñamos e implantamos arquitecturas de inteligencia artificial privada, estaciones de trabajo especializadas y bases de conocimiento locales (RAG) para organizaciones que exigen confidencialidad absoluta y soberanía sobre sus datos.
Esta entrada también está disponible en: