GUIDA DEFINITIVA E MONOGRAFIA • INFERENZA E SOVRANITÀ PRIVATA
AI on-premise: inferenza privata, strumenti e hardware
Sovranità tecnica, privacy assoluta e controllo totale: la guida pratica per scaricare, eseguire e padroneggiare modelli linguistici aperti sul proprio hardware senza fare affidamento sul cloud.
Perché inviare i dati più sensibili della tua azienda o dei tuoi progetti personali a server di terze parti quando puoi eseguire modelli all’avanguardia sul tuo computer? L’inferenza locale non è più dominio esclusivo degli ingegneri di sistema. Oggi, qualsiasi professionista o organizzazione può implementare potenti modelli linguistici (LLM), visione artificiale e sistemi RAG documentali con totale riservatezza e costi ricorrenti pari a zero.
I 4 grandi vantaggi dell’inferenza locale
🔒
Privacy e GDPR
I tuoi contratti, cartelle cliniche, codici e note non lasciano mai la tua macchina né vengono utilizzati per riqualificare modelli di terze parti.
💸
Zero commissioni e nessuna API
Elimina gli abbonamenti mensili di 20 $ al mese per utente e l’incertezza della fatturazione variabile per i token consumati.
⚡
100% autonomo e offline
Lavora su aerei, aree senza connettività o ambienti critici senza temere interruzioni del servizio da parte dei fornitori di servizi cloud.
🛡️
Sovranità senza censura
Modelli aperti con pesate verificabili, senza filtri aziendali imprevedibili o degrado silenzioso delle capacità.
1. Software essenziale: dal terminale al RAG privato in un clic
Non è più necessario compilare codice o gestire librerie complesse. Questi strumenti open source e applicazioni desktop rendono l’esecuzione dell’intelligenza artificiale a livello locale semplice come l’installazione di un programma tradizionale.
 ENTORNO DE ESCRITORIO
LM Studio: il modo più visivo per chattare con LLM
Scopri e scarica modelli quantizzati direttamente da Hugging Face, gestisci i parametri di inferenza e crea un server locale compatibile con l’API OpenAI.
 RAZONAMIENTO AVANZADO
DeepSeek in locale: scarica e utilizza passo dopo passo
Come eseguire pesi e distillazioni DeepSeek utilizzando Ollama o LM Studio per attività di programmazione offline, matematica e logica.
 RAG EMPRESARIAL PRIVADO
AnythingLLM: controlla i tuoi documenti senza perdite
La soluzione tutto in uno per indicizzare intere cartelle di PDF, DOCX e fogli di calcolo con incorporamenti locali e citazioni accurate alle fonti originali.
 AUTOMATIZACIÓN & WEBUI
Pinokio AI: installa ambienti complessi in 1 clic
Il browser che automatizza i terminali Git, gli ambienti Conda e le dipendenze Python per eseguire Stable Diffusion, Whisper, ComfyUI e FaceFusion senza errori.
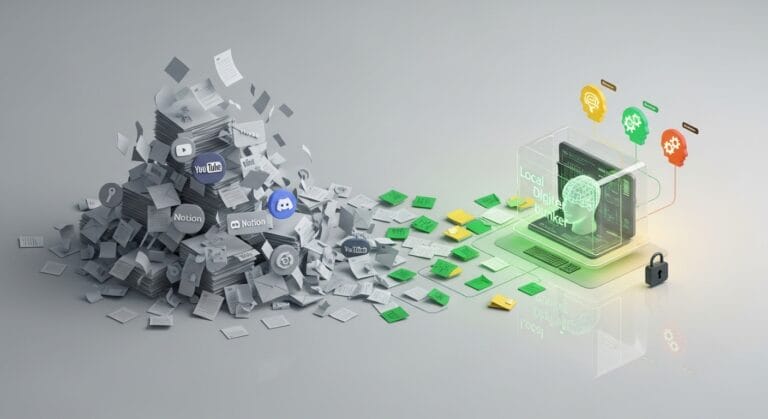 BASE DE CONOCIMIENTO LOCAL
Surfsense: l’alternativa privata a NotebookLM
Crea il tuo secondo cervello digitale e centralizza appunti, pagine web e documenti con la ricerca ibrida e la generazione di sintesi locale sul tuo computer.
2. Guida hardware: la regola d’oro di VRAM, GPU e NPU
Nell’intelligenza artificiale il fattore critico è la memoria video (VRAM) della scheda grafica. Se il modello ed il suo contesto rientrano completamente nella VRAM, la risposta è immediata; Se trabocca la RAM generale del sistema, la velocità di elaborazione diminuisce drasticamente.
8 GB di RAM
Modelli da 3B a 8B quantizzati a 4 bit (LLaMA 3.2 3B, Qwen 2.5 7B Q4). Ideale per principianti e assistenti di base.
12 GB di RAM
Modelli da 8B a 14B con finestre di contesto estese (token da 8k a 16k) senza colli di bottiglia su RTX 3060/4070.
16 GB di RAM
Il punto debole del professionista: DeepSeek-R1 Distill 14B, Qwen 14B e RAG stream con migliaia di pagine su RTX 4080 / Mac M-Series.
24 GB+ di RAM
Workstation di fascia alta (RTX 3090/4090): modelli 32B e 70B per codice avanzato e messa a punto.
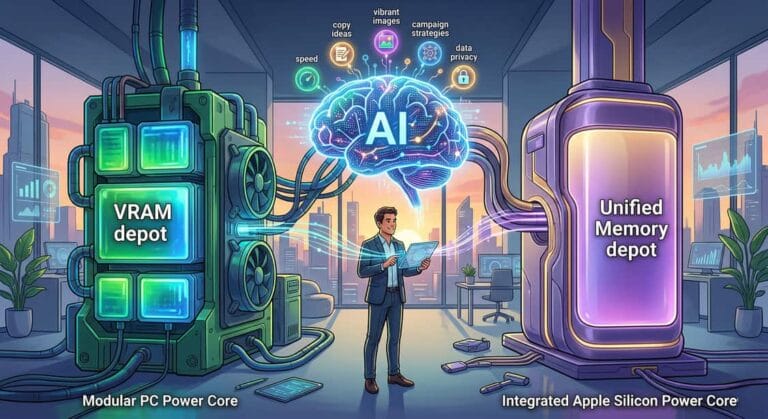 GUIDA ALL’ACQUISTO 2026
Vale la pena investire in un PC AI nel 2026?
Analizziamo il ROI rispetto agli abbonamenti cloud, ai componenti chiave (scheda, larghezza di banda PCIe, alimentatori) e alle configurazioni consigliate in base al budget.
 ARQUITECTURA & SILICIO
Nvidia: l’ecosistema dell’intelligenza artificiale dominante
Perché i core Tensor e la libreria CUDA sono lo standard indiscusso del settore per l’esecuzione di modelli senza incompatibilità tecniche.
 CHIPS NEURONALES INTEGRADOS
Processori con NPU: il nuovo standard
Cosa offrono le unità di elaborazione neurale integrate (Intel Core Ultra, AMD Ryzen AI, Snapdragon X) rispetto alle schede grafiche dedicate.
3. Modelli aperti e formato GGUF: spiegazione della quantizzazione
I modelli originali sono addestrati con pesi in virgola mobile a 16 bit (FP16), che richiedono fino a 2 byte per parametro. La quantizzazione del formato GGUF comprime matematicamente questi pesi a 4 o 5 bit (come lo standard Q4_K_M), riducendo il consumo di memoria del 70% con una perdita di precisione inferiore all’1%.
| Modello consigliato | Parametri | Formato/Quant. | VRAM consigliata | Specialità principale |
|---|---|---|---|---|
| Lama 3.2 3B | 3.2B | GGUF Q4_K_M | 4 – 6 GB | Laptop leggeri, riepiloghi rapidi e classifica |
| Qwen 2.5 7B | 7.6B | GGUF Q4_K_M | 8GB | Attività multilingue, di programmazione e generali di alta qualità |
| DeepSeek-R1 Distill 8B | 8.0B | GGUF Q4_K_M | 8 – 10GB | Ragionamento analitico profondo, logica matematica e auditing |
| DeepSeek-R1 Distill 14B / Qwen 14B | 14.7B | GGUF Q4_K_M | 12-16 GB | Sviluppo di software avanzato e agenti autonomi complessi |
| Qwen 2.5 32B / Lama 3.3 70B | 32B – 70B | GGUF Q4_K_S | 24 GB+ | Capacità paragonabili a GPT-4o per la produzione aziendale |
4. Le applicazioni professionali: dal segreto professionale alla società sovrana
L’intelligenza artificiale locale è l’unica alternativa praticabile per i settori soggetti al segreto professionale e a rigorose norme sulla protezione dei dati.
⚖️
Studi Legali e Consulenza
Audit di massa dei contratti, analisi della giurisprudenza e preparazione di rapporti senza che le informazioni del cliente tocchino server esterni.
🏥
Cliniche e settore sanitario
Sistematizzazione delle cartelle cliniche, delle note di consultazione e della letteratura scientifica nel rigoroso rispetto della RGPD e del segreto medico.
💻
Team di sviluppo e software
Completamento automatico, refactoring e debug del codice proprietario con modelli di codifica locali senza esporre la proprietà intellettuale.
🏭
PMI e Imprese Industriali
Basi di conoscenza aziendale interattive su manuali di macchinari, procedure interne e attenzione operativa in rete locale.
Domande frequenti sull’intelligenza artificiale in locale
Posso eseguire un potente LLM se non dispongo di una scheda grafica NVIDIA?
SÌ. I computer Apple Mac con processori Apple Silicon (M1/M2/M3/M4) sono dotati di memoria unificata ad altissima velocità che consente il funzionamento di modelli di grandi dimensioni senza una scheda dedicata. Sui PC con un processore x86 convenzionale, puoi anche eseguire modelli sulla CPU utilizzando LLaMA.cpp, anche se la velocità di creazione sarà notevolmente più lenta.
Qual è la differenza tra l’utilizzo di Ollama e LM Studio?
Ollama funziona principalmente come servizio back-end ottimizzato per il terminale e per l’integrazione con altre applicazioni o estensioni tramite API locale. LM Studio è un’applicazione desktop grafica progettata per gli utenti che preferiscono cercare modelli, regolare parametri e chattare visivamente senza utilizzare la console.
È legale utilizzare modelli open source come LLaMA o DeepSeek nelle aziende?
SÌ. Modelli come LLaMA 3 (licenza Meta community per organizzazioni con meno di 700 milioni di utenti attivi mensili) e DeepSeek (licenza MIT permissiva) consentono l’uso commerciale gratuito, inclusa l’integrazione in prodotti interni e rivolti ai clienti senza pagare royalties.
Hai bisogno di implementare server o stazioni AI locali nella tua azienda?
In ComunicaGenia progettiamo e implementiamo architetture private di intelligenza artificiale, workstation specializzate e basi di conoscenza locali (RAG) per organizzazioni che richiedono assoluta riservatezza e sovranità sui propri dati.
Questo articolo è disponibile anche in: